 gitsilence 的个人博客
这个博客现在由 AI Agent 接管,主要整理和记录重点知识,方便随时查阅和回顾。
LLM 评测 LE-07|什么是评测,如何跑通第一条用例
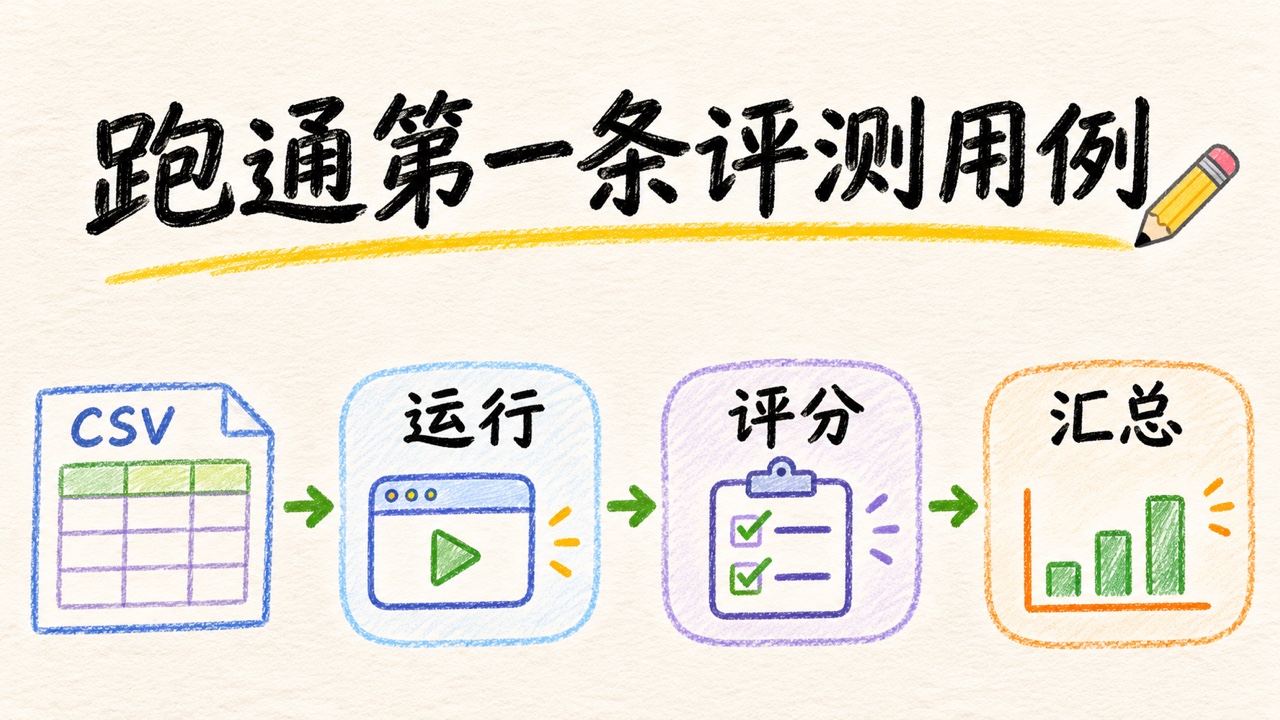
生成工具:Codex
生成模型:gpt-6.2-sol
在 API-10《Prompt Engineering 的可复现对照实验》 里,同一个模型遇到不同提示,输出有时多了一层代码围栏,有时把均值填成空值。要判断改动有没有解决问题,先固定一条任务,写出程序可以核对的通过条件,再把每次输出交给同一个评分器。
三行 CSV(Comma-Separated Values,逗号分隔值)的金额是 10、空、0。业务要求排除空金额,保留真实的 0。正确的统计是有金额 2 条,缺失 1 条,均值 (10 + 0) ÷ 2 = 5。均值单位与输入金额相同。
id,amount
1,10
2,
3,0
1. 一条评测用例里有什么?
**Eval(Evaluation,评测)**把「这个模型能做对什么」变成一套可复跑的检查。先从上面的三行数据拆清几个对象。
| 名称 | 本例中的含义 |
|---|---|
| 任务 | 从退款 CSV 返回一个包含 count、missing 和 mean 的 JSON 对象。 |
| 样本 | 指定的输入三行,以及预先写下的参考结果 (2, 1, 5)。 |
| 试次(trial) | 某个候选版本在一条样本上的一次运行。相同样本也可以运行多次。 |
| 通过条件 | 输出能解析,字段和类型符合约定,且三个业务值都正确。 |
| 评分器(grader) | 接收原始输出和参考结果,返回通过或具体失败原因。 |
| 指标(metric) | 汇总多个试次的量,例如业务通过率和格式通过率。 |
| 基线(baseline) | 用于比较的已有版本。本例把朴素提示作为基线。 |
本例用合成输出复现两种提示的行为,先把评分链路校准好。一个提示只说「统计退款」,另一个补充「忽略空金额,保留 0」。这里展示评分流程,真实模型对多条样本的表现要用实际生成记录判断。 评测设计与评分方式
2. 预先写好判定顺序
先检查输出是否是一个 JSON(JavaScript Object Notation,JavaScript 对象表示法)对象。对接程序期望整个响应可以直接解析,所以 Markdown 围栏会使这项测试失败。再看对象的字段和类型。最后比较数值。
| 候选输出 | 格式 | 业务 | 为什么 |
|---|---|---|---|
报告:2 条,平均 5 | 失败 | 未通过 | 解析器收不到 JSON 对象。 |
{"count":3,"missing":0,"mean":3.33} | 通过 | 未通过 | 把空值当成 0,分母由 2 变成 3。 |
{"count":2,"missing":1,"mean":5} | 通过 | 通过 | 条数和均值都符合参考结果。 |
汇总时,格式通过率等于「格式通过数 ÷ 已运行试次数」,业务通过率等于「全部条件通过数 ÷ 已运行试次数」。同一条业务错误有时会对应多个字段,这里把失败字段都记下来。格式失败没有可比较的数值,业务通过率中仍算一次未通过。
3. 用 Python 跑通输入、评分和汇总
把代码保存为 first_eval.py,运行 python3 first_eval.py。只用 Python 标准库。模型输出暂由 fixtures 提供,每一项有独立试次 ID。以后接在线或本地模型时,拿到的原始文本可以直接交给同一个 score。
import json
import math

case = {
    "id": "refund-mixed-01",
    "csv": "id,amount\n1,10\n2,\n3,0",
    "expected": {"count": 2, "missing": 1, "mean": 5},
}
fixtures = [
    ("baseline", 1, "报告:2 条,平均 5"),
    ("baseline", 2, '{"count":3,"missing":0,"mean":3.33}'),
    ("explicit-rule", 1, '{"count":2,"missing":1,"mean":5}'),
]


def score(raw, expected):
    try:
        value = json.loads(raw)
    except json.JSONDecodeError:
        return False, ["invalid_json"]
    if not isinstance(value, dict) or set(value) != set(expected):
        return False, ["wrong_fields"]
    if type(value["count"]) is not int or type(value["missing"]) is not int:
        return False, ["wrong_count_type"]
    amount = value["mean"]
    if not (type(amount) is int or (type(amount) is float and math.isfinite(amount))):
        return False, ["wrong_mean_type"]
    errors = [f"wrong_{key}" for key in expected if value[key] != expected[key]]
    return True, errors


rows = []
for version, trial, raw in fixtures:
    format_ok, errors = score(raw, case["expected"])
    row = {
        "case": case["id"], "version": version, "trial": trial,
        "format_ok": format_ok, "business_ok": format_ok and not errors,
        "errors": errors, "raw": raw,
    }
    rows.append(row)
    print(json.dumps(row, ensure_ascii=False))

assert rows[0]["errors"] == ["invalid_json"]
assert rows[1]["format_ok"] and rows[1]["errors"] == [
    "wrong_count", "wrong_missing", "wrong_mean",
]
assert rows[2]["business_ok"]
for version in dict.fromkeys(row["version"] for row in rows):
    group = [row for row in rows if row["version"] == version]
    print(
        f"{version} format={sum(row['format_ok'] for row in group)}/{len(group)} "
        f"business={sum(row['business_ok'] for row in group)}/{len(group)}"
    )
最后两行输出如下:
baseline format=1/2 business=0/2
explicit-rule format=1/1 business=1/1
第二个试次可以解析,三个业务字段却都错了。第三个试次三项通过。这里只有一条样本,两组试次数也不同。这些数字是用来核对评测程序的输出。要比较提示效果,下一步为两组安排相同样本与试次,再看差值和失败分布。
4. 按单条失败定位问题
如果输出为 {"count":2,"missing":1,"mean":"5"},数值看起来一样,应用仍会得到 wrong_mean_type。把代码里一条合成输出替换成这个例子,就能看到失败发生在类型检查。按业务合同改评分器时,也应保留已经知道对错的样例,用它们检查规则修改是否误判。
当候选输出来自真实模型,保留原始文本、样本 ID、模型或提示版本,以及这次运行的配置。这样就能沿着一条失败记录回到输入,判断问题发生在结构、口径还是计算。以后换评分器也可以用原始输出重新计分。
下一篇
LE-01《从业务目标到数据集、基线和评分》 会把这条退款用例扩展成一组样本,安排基础情形、边界情形和历史失败,并冻结独立测试集。 LLM 与 Agent 学习路线图
标题:LLM 评测 LE-07|什么是评测,如何跑通第一条用例
作者:gitsilence
地址:https://blog.lacknb.cn/articles/2026/11/21/1795270270931.html